科技未来
GPT images 2.5建筑出图评测:同一模型五档质量,积分相差六倍
发生什么OPENAI于9月8日发布最新的GPT images 2.5模型,jzaipro.com发布了对该模型建筑出图能力的评测,并刊载于青年建筑。[6]
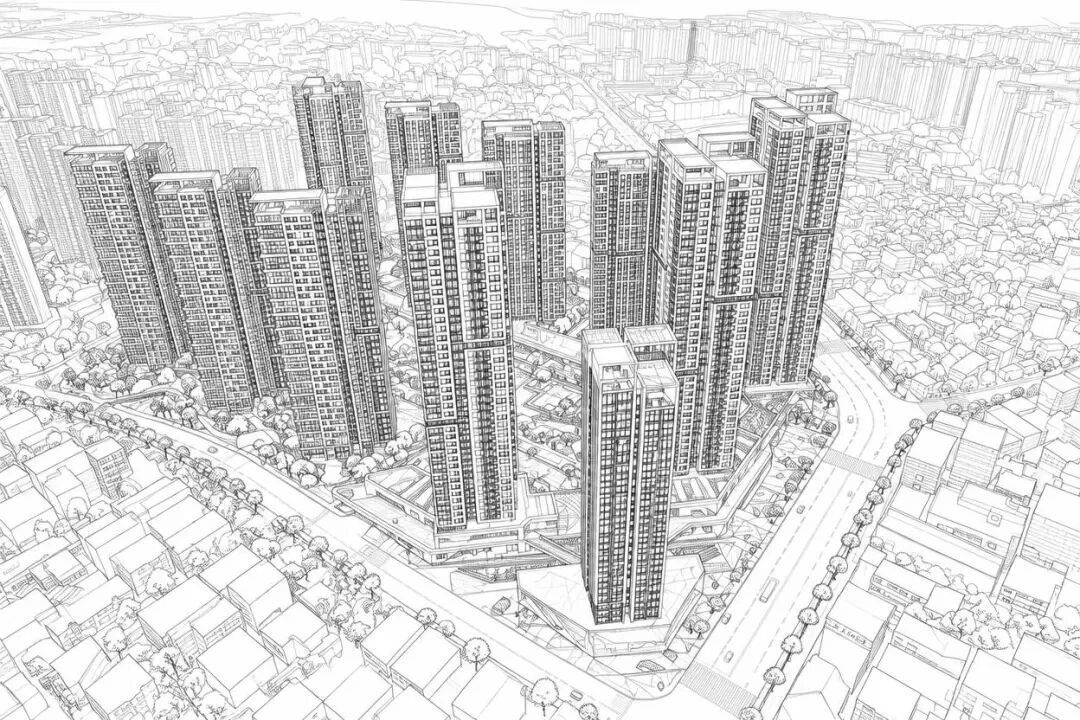
细节测试统一输出1K分辨率,提示词固定为“晴天实景图”,依次切换低、中、高、超高质量、最高质量五档,对应14/20/35/60/90积分,全部以鸟瞰视角进行,输入为一张建筑体块的SU线稿鸟瞰图。评测给出的结论是:低档14积分适合前期沟通与意向比选;中高档20至35积分为所内汇报、中间评审的性价比区间;正式文本、投标附件与需放大检视的关键鸟瞰图从超高质量60积分起。此外还测试了叠加一次15积分的jzaipro高清化,以及65积分的agent渲染,称断裂线脚被重新连接、远处环境回归可辨识的城市肌理。[6]
Why it matters文章给出的参照是成本与用途:过去一张合格的鸟瞰效果图外包渲染动辄三五千元、交付周期以天计。按用途而不是按参数上限选档,意味着AI出图的判断标准从“能不能生成”转向“这张图给谁看、需不需要放大检视”,这比模型排行更接近实际工作流。[6]
TOPOME Take评估这类评测,要先分清哪些是可复现的输入输出,哪些是平台方给的结论。本次测试的变量是锁定的(1K分辨率、固定提示词、同一张线稿、鸟瞰视角),但档位取舍的结论来自平台方,且测试对象是垂直出图场景,不代表通用图像生成能力。[6]
证据与观察评测与图片均来自jzaipro.com,并由青年建筑转载,属平台方发布的推广性内容:文章同时介绍JZAI采用积分制、积分永久有效、不收取会员费。厂商自述不构成独立验证,档位效果差异与“接近专业渲染器输出质感”的描述需以自身工作流复测。[6]
*
平台方发布的模型评测与推广内容,属厂商自述,效果未经独立验证。来源:青年建筑
huashu-report开源:把“不许编数字”写成编译器的硬约束
作者花叔正式开源 huashu-report(MIT协议):开工第二步先建数据表.json,每个要进正文的数字都带数值、口径、样本量、出处与verified位,正文引用它时靠函数渲染成上标编号,编译器会检查“正文引用了数据表里没有的条目”,从而锁死数字来源;口径写不出一句完整的话就不能用,作者举例Qwen报告中四个流传的下载量数字实际口径互不兼容。规则按“机器能不能判定”分三层:能写成函数或计数的判据全部挪进编译器或做成自检,只有机器判不了的内容留在手册里。渲染后仍会把PDF逐页渲成PNG人工复检,因为负值柱被画成零高度、标注被版心切掉等缺陷机械自检查不出来。skill 分六种原型:咨询deck、研报型、学术型、论文型、调查型、科普型,橙皮书属科普型。以上为作者自述的工作方法与产出清单,四期橙皮书收入从2.35万元降至0.49万元也为其个人披露,未经独立核验。[7]
*
作者个人开源项目的方法复盘,数据与结论均为本人披露。来源:Cubox收藏
后续观察
GPT images 2.5 的建筑出图评测由平台方发布,属厂商自述,独立复测与长期稳定性待观察。[6]
huashu-report 为作者个人开源项目,规则有效性来自作者自测,需独立复现。[7]
参考来源
材料日期不等于事件发生日。事实与编辑观点分别阅读,计划、背景研究与来源限制保留原有说明。
- GPT images 2.5建筑出图评测:同一模型五档质量,积分相差六倍青年建筑 · 2026-09-14
- huashu-report开源:把“不许编数字”写成编译器的硬约束Cubox收藏 · 2026-09-14